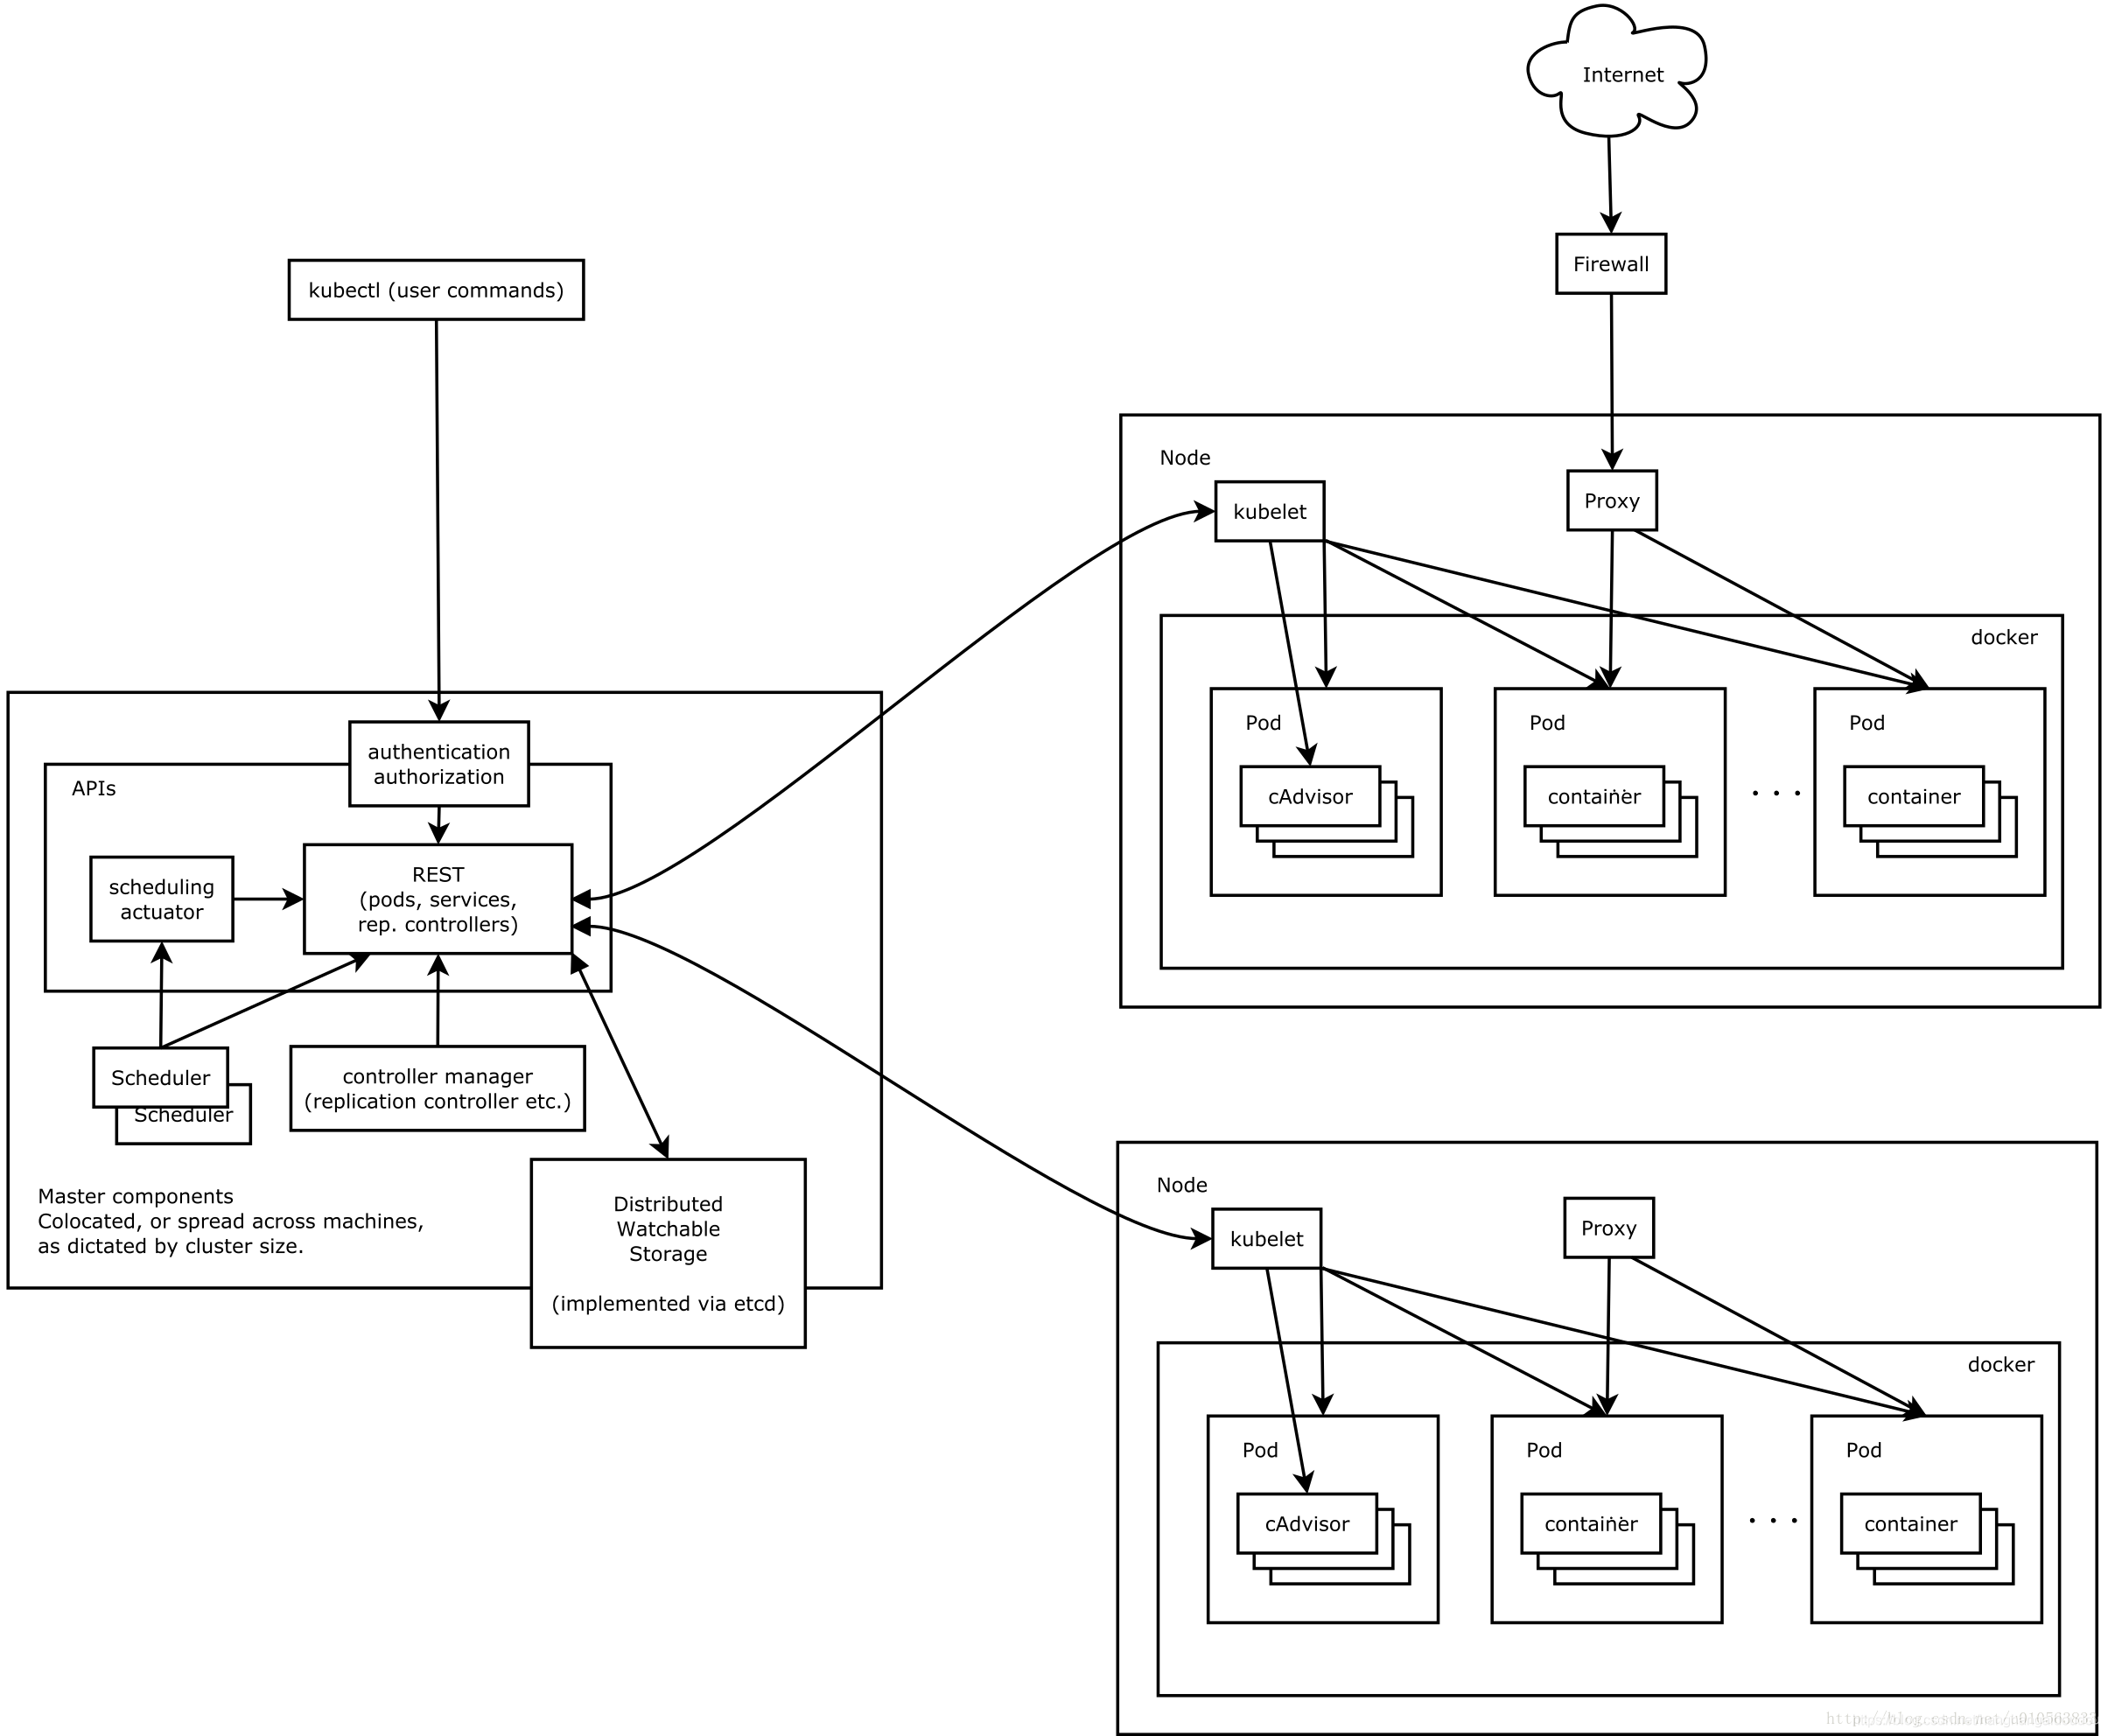
最近看了一些云安全的面经,发现技术面的相关问题我很多都答不上来,前段时间公有云的学习也莫名其妙的没有下文了,特别是有了ai之后独立思考的能力渐渐缺失,很难独立去完成靶场了,索性换个方向先简单了解一下,从公有云转到云原生上
学习线路:
基石:容器化(Docker) Dockerfile,把应用打包成标准镜像。这是云原生一切应用的“交付物”。核心:Kubernetes 编排 Pod、Deployment、Service 等核心对象。这是你需要投入最多时间的阶段。Minikube 的作用就在于此,让你能实际部署、观察、调试这些资源。进阶:微服务与流量治理 效率:DevOps 与 CI/CD
docker
Docker 是一个开源的应用容器引擎,基于 Go 语言 并遵从 Apache2.0 协议开源。
Docker 可以让开发者打包他们的应用以及依赖包到一个轻量级、可移植的容器中,然后发布到任何流行的 Linux 机器上,也可以实现虚拟化。
容器是完全使用沙箱机制,相互之间不会有任何接口(类似 iPhone 的 app),更重要的是容器性能开销极低。
docker 常用基本命令 docker pull 镜像名:版本号 下载镜像
docker images 查看本地下载的镜像
docker ps 查看正在运行的容器
docker run -it 镜像名:版本号 运行容器
docker exec -it 容器id sh 进入容器
docker rm -f 容器id 删除容器
docker rmi 镜像id 删除镜像
docker tag 镜像id 镜像名:版本号 给镜像打标签
docker build -t 镜像名:版本号 . 构建镜像
docker commit -a="作者" -m="说明" 容器id 镜像名:版本号 提交容器变更到镜像
docker history 镜像名:版本号 查看镜像的构建历史
dockerfire 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 FROM ubuntu:18.04 RUN apt-get update RUN apt-get install -y vim RUN apt-get update && apt-get install -y curl COPY ./a /a ADD ./b /b WORKDIR /a CMD ["tail" , "-f" , "/dev/null" ] ENTRYPOINT ["/manager" ]
k8s学习 之前在学aws的时候的学习经费还有好多没有用,再不用就浪费了,再开一台vps来学云原生
学习k8s肯定需要自己上手实操一下,这里推荐minikube,它能在你的本地电脑上快速拉起一个单节点 K8s 集群,让你零成本地练习所有核心操作,且官方教程都是基于它编写,生态中的大多数入门示例都能直接跑通。
安装 minikube start | minikube 中文
以linux为例
1 2 curl -LO https://github.com/kubernetes/minikube/releases/latest/download/minikube-linux-amd64 sudo install minikube-linux-amd64 /usr/local/bin/minikube && rm minikube-linux-amd64
启动集群
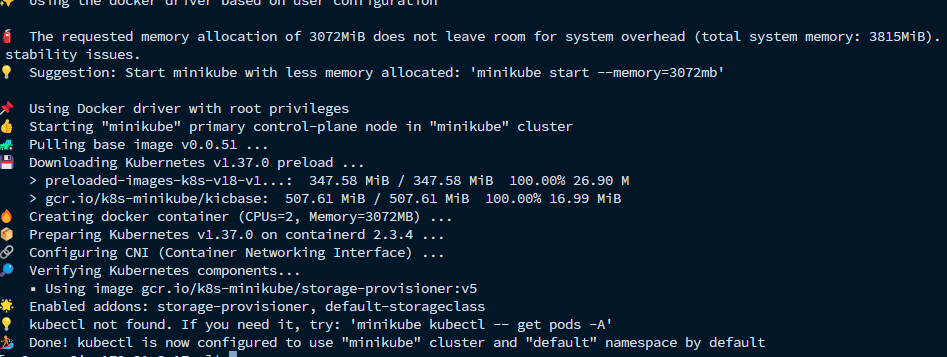
1 minikube start --driver=docker --v=7
这样就是下载启动成功了
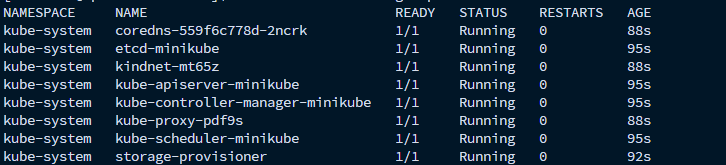
验证一下
1 minikube kubectl -- get pods -A
易用配置
添加再末尾
1 2 alias kubectl="minikube kubectl --" source <(kubectl completion bash)
这是将minikube kubectl --这一长坨命令简化成kubectl,方便操作,且模拟环境更加完善
-- 是 Unix/Linux 的通用约定,表示**“选项到此为止,后面的都是位置参数(要传给子命令的内容)”**。
也就是说如果没有--之后的命令get pods -A就会被根命令minikube解析,而这个命令是属于kubectl的,这样解析肯定会报错
删除集群
k8s相关概念 Pod Pod是Kubernetes中最小的可部署计算单元,您可以在其中创建和管理它。
Pod的共享上下文 包括一组Linux命名空间、cgroups以及其他可能的隔离机制。在Pod的上下文中,各个应用程序可以进一步实现子隔离。
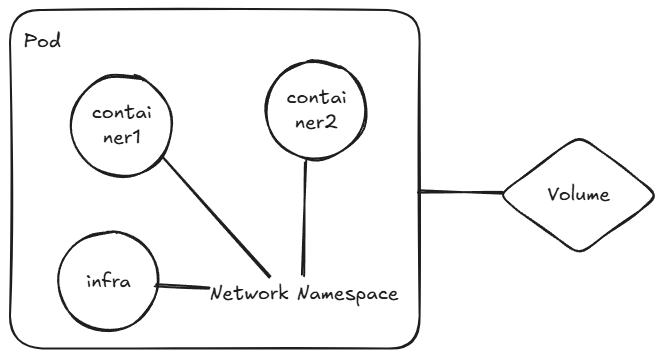
Pod类似于一组容器 ,这些容器共享命名空间和文件系统卷。
在Kubernetes集群中,Pod主要有两种使用方式:
运行单个容器的Pod。这种“一个Pod一个容器”的模式是最常见的Kubernetes用例。此时,您可以将Pod视为单个容器的包装层,Kubernetes直接管理Pod而非容器本身。
运行多个需要协同工作的容器的Pod。Pod可以封装由多个紧密耦合的容器组成的应用程序,这些容器需要共享资源。
Namespace
管什么
Pod 内是否共享
network 网络接口、IP、端口
共享(同一 IP,端口不能冲突)
mount 文件系统挂载点
默认隔离(各有各的根文件系统)
pid 进程 ID
默认隔离(可配置共享)
ipc 进程间通信(信号量、共享内存)
共享
uts 主机名、域名
共享(同一 hostname)
user 用户和 UID 映射
默认隔离
cgroup cgroup 视图
共享
time 系统时钟偏移
默认隔离
network :Pod 内容器共用 IP 和端口空间,所以 localhost 能互相访问,但同一端口只能被一个容器占用。ipc :可以用 System V IPC 或 POSIX 消息队列通信。uts :共享主机名,hostname 命令看到的是同一个。
每个 Pod 启动时,kubelet 会先拉起一个极小的容器,镜像叫 pause(infra container)(通常几十 KB 到几百 KB)。它只做一件事:
1 2 3 4 for (;;) { pause(); }
它的作用就是占住并持有 Pod 级别的 namespace :
创建 network namespace,并配置好 Pod 的 IP
创建 ipc、uts namespace
作为 cgroup 的挂载点
然后,Pod 里的所有业务容器在启动时,通过 --net=container:<pause容器ID> 这类方式,加入到 pause 容器已经创建好的 namespace 里 。
也就是说
Pod的共享namespace 由pause容器创建并持有,业务容器都是”加入者”
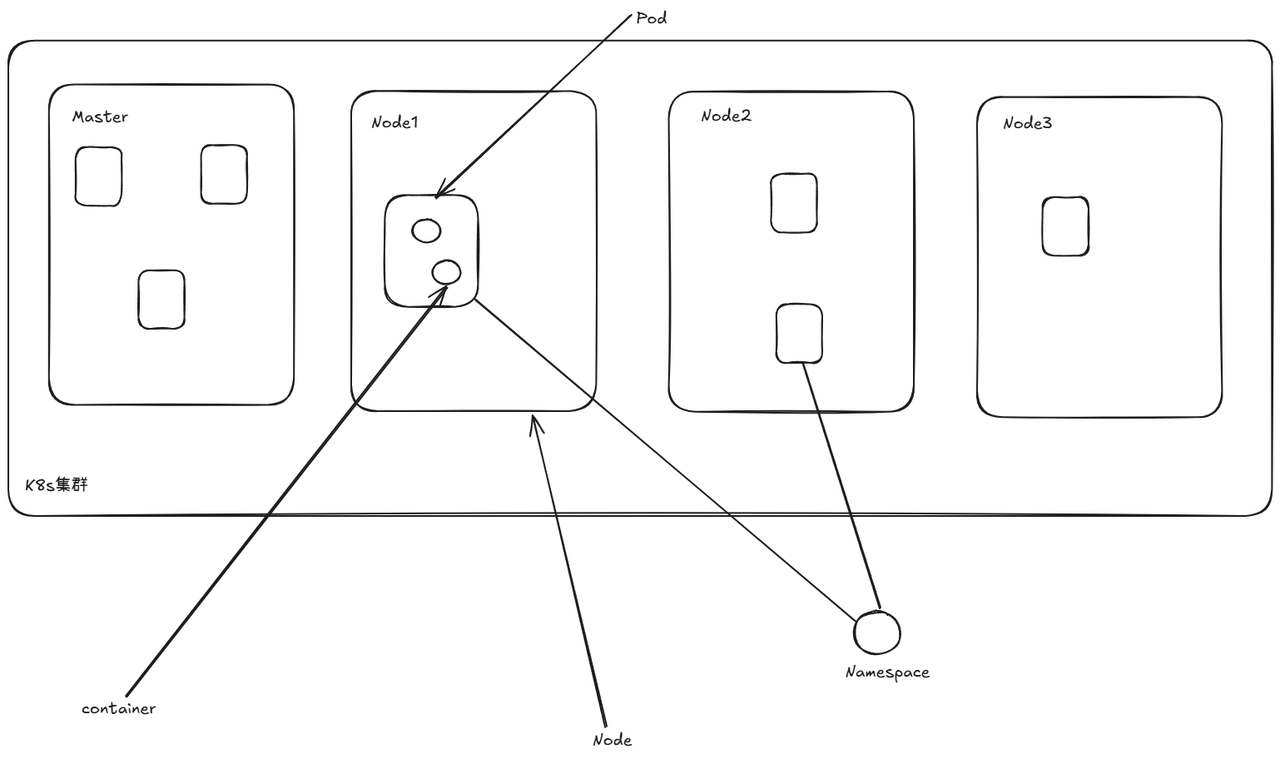
集群(Cluster) Kubernetes 集群是由一组节点(Node)组成的集合,用于运行容器化应用程序。集群由控制平面(Control Plane)和工作节点(Worker Node)组成。
控制平面 :负责管理集群的状态和调度任务,包括 API Server、Scheduler、Controller Manager 和 etcd 等组件。工作节点 :运行实际的容器化应用程序,每个节点包含 kubelet、kube-proxy 和容器运行时(如 Docker 或 containerd)。
节点(Node) 节点是 Kubernetes 集群中的工作单元,可以是物理机或虚拟机。节点分为两种类型:
Master 节点 :运行控制平面组件,负责集群管理。Worker 节点 :运行应用程序容器,由控制平面调度。
命名空间(Namespace) 命名空间是 Kubernetes 中用于资源隔离的逻辑分区。通过命名空间,可以将集群资源划分为多个虚拟集群,适用于多团队或多环境场景。
默认命名空间 :default,未指定命名空间的资源默认属于此命名空间。系统命名空间 :如 kube-system,用于运行 Kubernetes 系统组件。
Pod 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 apiVersion: v1 kind: Pod metadata: name: my-app-pod namespace: default labels: app: my-app tier: backend version: "1.0" annotations: description: "This is a sample application pod" maintainer: "devops-team" spec: restartPolicy: Always containers: - name: main-container image: nginx imagePullPolicy: IfNotPresent command: ["nginx" ] args: ["-g" , "daemon off;" ] ports: - name: http containerPort: 80 protocol: TCP - name: https containerPort: 443 protocol: TCP env: - name: ENVIRONMENT value: "production" - name: LOG_LEVEL value: "info" resources: requests: memory: "128Mi" cpu: "250m" limits: memory: "256Mi" cpu: "500m" livenessProbe: httpGet: path: / port: 80 initialDelaySeconds: 30 periodSeconds: 10 timeoutSeconds: 5 failureThreshold: 3 readinessProbe: httpGet: path: / port: 80 initialDelaySeconds: 5 periodSeconds: 5 timeoutSeconds: 3 failureThreshold: 1
以上是一个比较全面的Pod模板
关于apiVersion K8s 把所有 API 分组,每组有版本。不同资源属于不同的组:
资源
apiVersion
Pod、Service、ConfigMap
v1(核心组)
Deployment、DaemonSet
apps/v1
Job、CronJob
batch/v1
Ingress
networking.k8s.io/v1
Role、RoleBinding
rbac.authorization.k8s.io/v1
apiVersion 写错,K8s 就找不到这个资源类型,直接报错。
此处v1 这种只有版本、没有组名 的,是 K8s 最早期、最基础的资源,叫核心组 :
包含:
Pod
Service
ConfigMap
Secret
Namespace
Node
PersistentVolume
PersistentVolumeClaim
特点 :最基础、最稳定,从 K8s 诞生就有。
1 2 3 4 5 name: btop251 namespace: default uid: ac987043-77fb-49e6-ae26-2b1a337462ae resourceVersion: "6287" creationTimestamp: "2026-10-14T06:46:26Z"
uid:Pod 的全局唯一 ID ,即使删了重建同名 Pod,uid 也不同resourceVersion:版本号,K8s 内部用乐观锁,每次修改递增namespace:default, YAML 没写,默认落到 defaultlables:可以理解为标签,将对应的资源分类,方便快速查找,有字数上限description:描述,给人看的,让你知道这玩意是干嘛用的,没有字数上限
spec(期望状态) 这是核心部分。你希望对应资源的状态,没写的属性会使用默认值,注意这个是期望而不是命令
比如说
表示的是我希望这里有三个pod,而不是给我创建三个pod,她的判定标准是最终的结果是否为三个pod,多退少补,而不是实际的执行过程创建三个pod
status (实际状态) 这部分是 K8s 写的,你只读。 它反映 Pod 的真实情况。先不管
实践 在实际情况中可以通过先创建一个yaml文件来来此一个pod资源
1 2 3 4 5 6 7 8 9 10 11 apiVersion: v1 kind: Pod metadata: name: btop251 spec: containers: - name: btop251 image: alpine command: ["/bin/sh" ] stdin: true tty: true
创建好之后可以通过
1 kubectl apply -f pod.yaml
or
1 kubectl create -f pod.yaml
来创建资源,apply不仅可以创建资源,也可以用于修改资源,所以在实际情况下往往都是直接通过该命令,很少使用create
通过以下命令查看这个pod的相关配置信息
1 kubectl get po btop251 -oyaml
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 apiVersion: v1 kind: Pod metadata: annotations: kubectl.kubernetes.io/last-applied-configuration: | {"apiVersion":"v1","kind":"Pod","metadata":{"annotations":{},"name":"btop251","namespace":"default"},"spec":{"containers":[{"command":["/bin/sh"],"image":"alpine","name":"btop251","stdin":true,"tty":true}]}} creationTimestamp: "2026-10-14T06:46:26Z" generation: 1 name: btop251 namespace: default resourceVersion: "6287" uid: ac987043-77fb-49e6-ae26-2b1a337462ae spec: containers: - command: - /bin/sh image: alpine imagePullPolicy: Always name: btop251 resources: {} stdin: true terminationMessagePath: /dev/termination-log terminationMessagePolicy: File tty: true volumeMounts: - mountPath: /var/run/secrets/kubernetes.io/serviceaccount name: kube-api-access-46vw5 readOnly: true dnsPolicy: ClusterFirst enableServiceLinks: true nodeName: minikube-m02 preemptionPolicy: PreemptLowerPriority priority: 0 restartPolicy: Always schedulerName: default-scheduler securityContext: {} serviceAccount: default serviceAccountName: default terminationGracePeriodSeconds: 30 tolerations: - effect: NoExecute key: node.kubernetes.io/not-ready operator: Exists tolerationSeconds: 300 - effect: NoExecute key: node.kubernetes.io/unreachable operator: Exists tolerationSeconds: 300 volumes: - name: kube-api-access-46vw5 projected: defaultMode: 420 sources: - serviceAccountToken: expirationSeconds: 3607 path: token - configMap: items: - key: ca.crt path: ca.crt name: kube-root-ca.crt - downwardAPI: items: - fieldRef: apiVersion: v1 fieldPath: metadata.namespace path: namespace status: conditions: - lastProbeTime: null lastTransitionTime: "2026-10-14T06:46:26Z" observedGeneration: 1 status: "True" type: PodReadyToStartContainers - lastProbeTime: null lastTransitionTime: "2026-10-14T06:46:26Z" observedGeneration: 1 status: "True" type: Initialized - lastProbeTime: null lastTransitionTime: "2026-10-14T06:46:30Z" observedGeneration: 1 status: "True" type: Ready - lastProbeTime: null lastTransitionTime: "2026-10-14T06:46:30Z" observedGeneration: 1 status: "True" type: ContainersReady - lastProbeTime: null lastTransitionTime: "2026-10-14T06:46:26Z" observedGeneration: 1 status: "True" type: PodScheduled containerStatuses: - containerID: containerd://7ce52c74c4aac9c2a5b95701e7ca540ffb8545e42110d5c221aa6529cb9633a4 image: docker.io/library/alpine:latest imageID: docker.io/library/alpine@sha256:294b683cb724975bec92580e1e685676bd4b50bda910ddb8c51d4cabeaec77e6 lastState: {} name: btop251 ready: true resources: {} restartCount: 0 started: true state: running: startedAt: "2026-10-14T06:46:30Z" user: linux: gid: 0 supplementalGroups: - 0 - 1 - 2 - 3 - 4 - 6 - 10 - 11 - 20 - 26 - 27 uid: 0 volumeMounts: - mountPath: /var/run/secrets/kubernetes.io/serviceaccount name: kube-api-access-46vw5 readOnly: true recursiveReadOnly: Disabled hostIP: 192.168 .49 .3 hostIPs: - ip: 192.168 .49 .3 observedGeneration: 1 phase: Running podIP: 10.244 .1 .4 podIPs: - ip: 10.244 .1 .4 qosClass: BestEffort resources: {} startTime: "2026-10-14T06:46:26Z"
删除资源
1 kubectl delete pod btop251
or 通过yaml来删除
1 kubectl delete -f pod.yaml
节点调度 1 2 3 4 5 6 7 8 9 10 11 12 $ kubectl explain pod.spec.nodeSelector KIND: Pod VERSION: v1 FIELD: nodeSelector <map[string]string> DESCRIPTION: NodeSelector is a selector which must be true for the pod to fit on a node. Selector which must match a node's labels for the pod to be scheduled on that node. More info: https://kubernetes.io/docs/concepts/configuration/assign-pod-node/
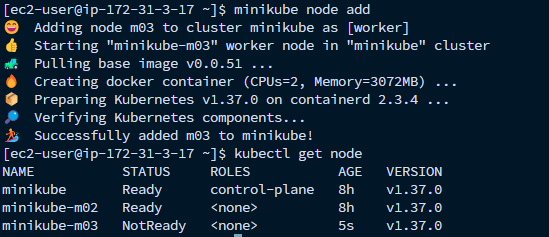
先创建三个node节点,因为创建节点时第一个节点为控制节点有一个taint(污点),普通 Pod 没有对应的 toleration(容忍) ,就不会被调度上去。所以需要用两个普通节点来做实践
一开始我直接通过
1 kubectl start --driver=docker -n 3
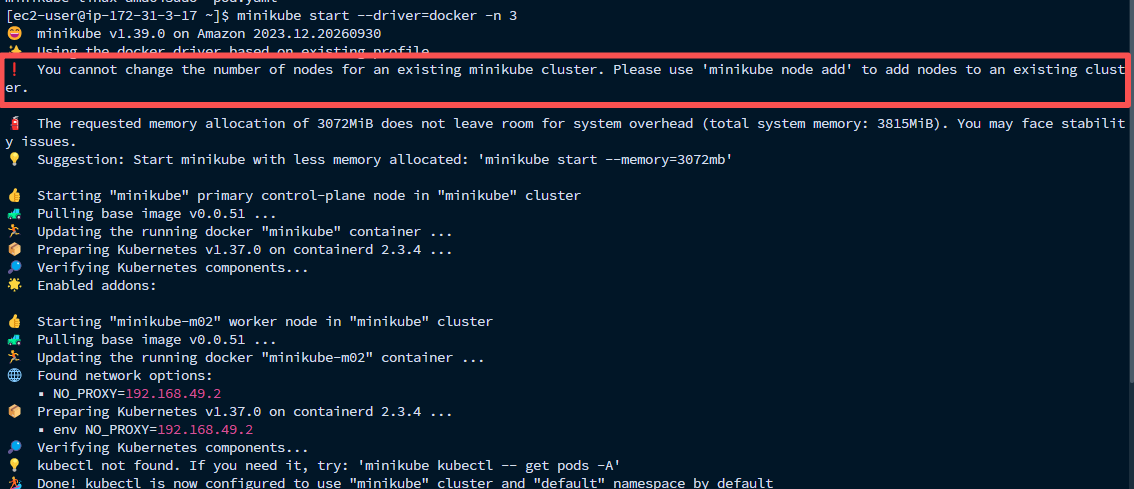
想直接创建三个节点,但是忘记了上一次事件的时候创建的节点没有删除于是触发报错
已经创建的资源,某些属性是“不可变”的,想改只能删了重建,或者用专门的“增量”命令。
类似于上面的通过create来创建pod节点,如果想要修改数量或者属性只能通过apply,这个apply可以当作是修改状态,而create只能用于创建
没问题了
首先要知道每个node对应的资源是不一样的,有些node上会安排gpu算了来跑机器学习,有些
先创建一个带有labels的pod
1 2 3 4 5 6 7 8 9 10 11 12 13 14 apiVersion: v1 kind: Pod metadata: name: btop251 spec: nodeSelector: gpuNode: "true" containers: - name: btop251 image: alpine command: ["/bin/sh" ] stdin: true tty: true
注意这里的gpuNode的vaule是”true”,因为在给lables的时候对应的vaule往往是string格式,默认会给出单引号,但是想true,false这些特殊字符,如果不打上双引号会当作布尔类型的字符来处理
1 kubectl apply -f pod.yaml
1 2 3 $ kubectl get po NAME READY STATUS RESTARTS AGE btop251 0/1 Pending 0 7s
注意到状态STATUS为pending,这是一种常见的报错,原因是在创建pod是找不到gpuNode为true的节点,所以创建被挂起而没有跑起来,需要我们给一个节点打上对应的标签
1 2 3 4 $ kubectl label node minikube-m03 gpuNode=true $ kubectl get po NAME READY STATUS RESTARTS AGE btop251 1/1 Running 0 8m38s
删除label
1 kubectl label node minikube-m03 gpuNode-
< NEWER
云原生学习02-pod调度
OLDER >
面试八股之owasptop10